語音模型筆記
GPT-Live-1
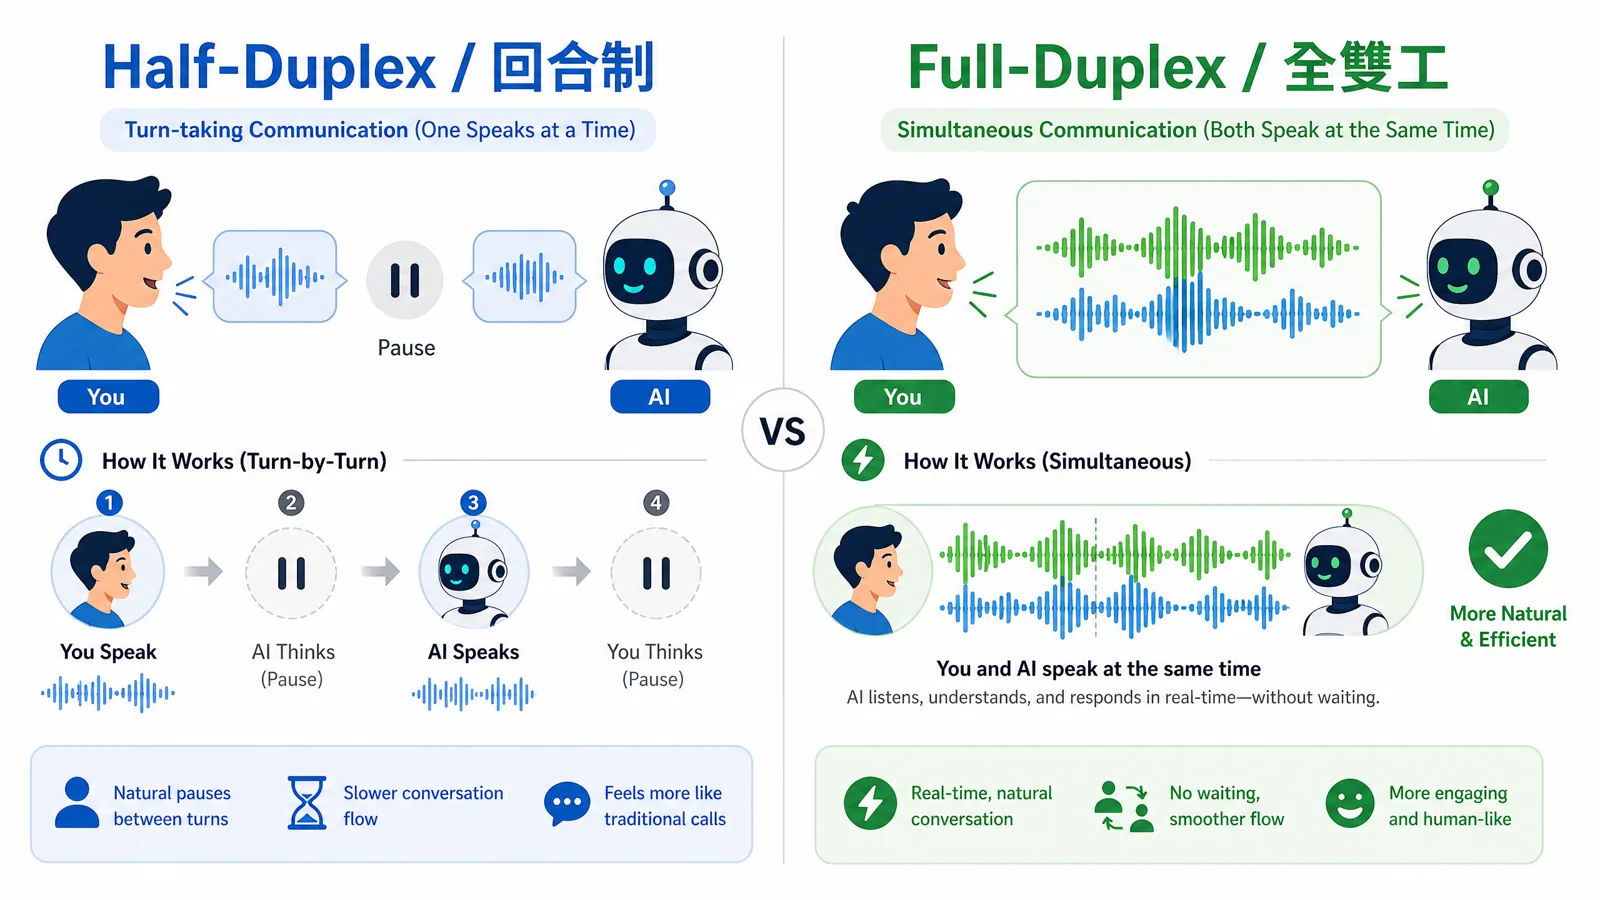
GPT-Live-1 是 2026 年 9 月 OpenAI 推出的新一代實時語音互動模型。核心目標是打破傳統「輪流發言」的限制,提供如真人對話般順暢、自然的雙向語音互動體驗。
技術重點
- 全雙工架構(Full-Duplex Speech Engine):允許在說話時同步接收音訊,能即時應對使用者的插話或自然中斷。
- 前後端任務委派(Delegation Mode):當使用者提出複雜需求時,GPT-Live-1 會將任務丟給後端模型執行。在後端運算(如查詢資料庫或上網)的同時,前端語音能繼續與使用者聊天,避免尷尬的空白等待。
- 多協議傳輸支援:API 支援 WebRTC(低延遲客戶端直連)與 WebSocket(伺服器端串流),音訊格式涵蓋 16/24kHz PCM 及電信級 8kHz G.711。
- 更強的聆聽與抗噪能力:能自動分辨背景噪音(如車聲、旁人對話),集中在使用者主聲音上;並能識別「需要安靜等待」指令。
- 內建浮水印技術(SynthID):生成音訊內建 SynthID 浮水印,並提供公開及 API 驗證工具供開發者辨識音訊來源。
| 版本 | 適用方案 | 特色 |
|---|---|---|
| GPT-Live-1 | Go、Plus、Pro 付費用戶 | 更強的推理與對話能力,後台接 GPT-5.5 |
| GPT-Live-1 mini | 免費(Free)用戶 | Free 用戶的預設版本,功能與用量依方案而定 |
目前可行
- 真人生動對話與即時打斷:使用者可在模型發言途中隨時插話切換主題,模型會立即適應而非強行講完。
- 邊聊邊進行複雜搜尋/推理:支援一邊語音對話,一邊執行背景工具(Tool Calling)建立文件或執行網路搜尋。
- 即時雙向翻譯:可用於跨語言的實時語音對譯與多口音溝通。
- 語音與文字無縫切換:語音對話過程中可同步產出逐字稿與結構化文本,方便會後查閱與接續文字編輯。
技術上限制
- 打斷邏輯與後端運算解耦:語音被使用者打斷(如說「等一下」)時,並不等於取消後端已發出的 API 或業務指令,邏輯上需另外傳遞取消信號。
- 逐字稿片段不代表完整意圖:在全雙工情境下,即時串流的語音轉文字(Transcript)可能包含重疊聲音或錯誤片段,不能直接作為最終業務確認的依據。
- 暫不支援影片/螢幕分享:發布初期,GPT-Live 尚不支援 ChatGPT 搭配影片或即時螢幕分享的語音功能。
- 多語言品質差異:雖然支援多國語言與口音,但在部分語言中仍可能帶有非母語口音或流暢度不足。
費用分為「語音連線時間費(每分鐘約 $0.05 美元)」與「後端模型調用 Token 費」。建議開發者依任務複雜度合理配置後端模型,以優化整體 API 支出。
可行性評估
1. 建議應用的潛力場景
- 智慧金融客服:替換傳統語音選單,實現自然語言電話對答;客戶打斷或更正資訊時不卡頓。
- 內部 IT/行內:員工可邊通話邊查詢系統權限或報修,AI 在通話中調用 API 並告知進度。
- 理專/業務員行動對話助手:外出時透過語音查詢客戶資料或建檔,並自動轉為後台文字紀錄。
2. 資訊處導入需評估的關鍵點
- 系統架構(SIP/Telephony 整合):需透過 WebRTC 或 WebSocket 與現有 VoIP/CTI 電信架構對接,需評估網路延遲與資安隔離。
- 合規與狀態安全(State Management):由於語音串流的不確定性,「交易類指令」(如轉帳、修改權限)絕對不可僅憑語音即時判斷,必須在語音交互後設有二階段確認機制(Two-step verification)。
- 資安與來源驗證合規:系統已具備 SynthID 浮水印與驗證 API,可滿足金融監管對「AI 生成內容標示與可追溯性」的要求。